Es kann vorkommen, dass wir einen DNA-Marker – das heißt eine Position in Ihrer DNA – nicht lesen können. Beim Suchen von Verwandten und zum Abgleichs mit des Herkunfts spielt das meist keine Rolle, aber bei der Auswertung der Merkmale schon eher.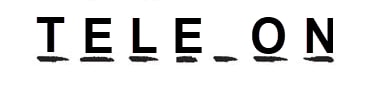
Zum Glück hilft uns die Biologie in solchen Fällen weiter. Wie beim Buchstabenraten, wo man den fehlenden Buchstaben anhand der umliegenden Buchstaben errät, können wir anhand der DNA in der Umgebung auf den fehlenden Marker schließen. In der Wissenschaft spricht man dabei vom Hochrechnen.
So funktionieren Hochrechnungen
Möglich werden Hochrechnungen durch zwei Faktoren.
Erstens sind die vielen hunderttausend Marker, die wir auswerten, nacheinander in langen DNA-Schlangen angeordnet, den Chromosomen. Und zweitens erben wir in der Regel ganze DNA-Abschnitte von unseren Eltern, nicht einzelne Marker.
Das bedeutet, dass man nicht nur den Marker für – beispielsweise – trockenes Ohrenschmalz von einem Elternteil erbt, sondern gleichzeitig viele weitere Marker in der Umgebung dieses Ohrenschmalz-Markers. Wir haben also einen Abschnitt mit vielen Markern, zu denen auch der für das trockene Ohrenschmalz gehört.
Das ist dann wie beim Buchstabenraten, wenn ein einziger Buchstabe im ganzen Wort fehlt: TELE_ON. Sicherlich haben Sie erraten, dass hier das F fehlt und das ganze Wort „Telefon“ heißt. Stellen Sie sich jetzt vor, dass das F der Marker für trockenes Ohrenschmalz ist. Selbst wenn wir das F in unserer Analyse nicht erkennen, können wir anhand der umliegenden Marker annehmen, was an dieser Stelle zu finden ist.
Der Marker für feuchtes Ohrenschmalz wäre von anderen Buchstaben umgeben. Stellen Sie sich vor, dass es sich um das T im Wort „Fenster“ handelt. Wenn wir also den Marker für den Ohrenschmalztyp nicht auslesen können, brauchen wir uns nur die umliegenden Marker anzusehen: Wenn wir TELE_ON sehen, wissen wir, dass diese Person den Marker für trockenes Ohrenschmalz hat. Und wenn wir FENS_ER sehen, wissen wir, dass diese Person den Marker für feuchtes Ohrenschmalz hat.
Das DNA-Alphabet
Natürlich enthält die DNA keine richtigen Wörter, aber sie verwendet eine Art Alphabet, das aus den vier Buchstaben A, C, G und T besteht.
Im Marker für den Ohrenschmalztyp, rs17822931, steht ein T für trockenes Ohrenschmalz und ein C für feuchtes Ohrenschmalz. Wenn wir den betreffenden Buchstaben von rs17822931 nicht auslesen können, können wir von den umliegenden Markern darauf schließen.
Hier ein Beispiel aus der Praxis für so eine Hochrechnung: Das Beispiel zeigt nur einige wenige Marker um den Ohrenschmalz-Marker herum, vermittelt aber eine Vorstellung davon, wie das Ganze funktioniert.
Hier sind einige der Marker aus der Umgebung des Markers für trockenes Ohrenschmalz (der rote Buchstabe):
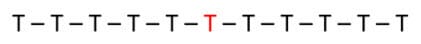
Und hier sind einige der Marker aus der Umgebung des Markers für feuchtes Ohrenschmalz (der rote Buchstabe):
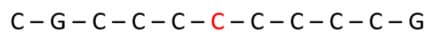
Nehmen wir nun an, genau den Marker für den Ohrenschmalztyp könnten wir nicht lesen, haben aber Folgendes vorliegen:
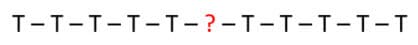
Welches ist dann wohl der fehlende Marker? Richtig: der Marker für trockenes Ohrenschmalz.
Wie zuverlässig sind Hochrechnungen?
Hochrechnungen sind zwar insgesamt zuverlässig, haben aber dennoch eine höhere Fehlerquote als das direkte Auslesen der DNA. Dafür gibt es viele Gründe.
Manchmal sind die umliegenden Marker einander so ähnlich, dass eine Unterscheidung schwerfällt. Oder der Marker, der sich nicht lesen lässt, befindet sich am Ende eines Chromosoms und hat nur auf einer Seite benachbarte Marker. Dies sind nur zwei Gründe, aus denen Hochrechnungen manchmal weniger zuverlässig sind als das direkte Auslesen der DNA. Solche Probleme machen Hochrechnungen für drei der von uns untersuchten Merkmale besonders knifflig: rotes Haar, Sommersprossen und die Wahrnehmung von Spargel-Urin.